Agent-Ready-SaaS-Dokus: Die Dateien, die KI-Agenten lesen

Generative Engine Optimization (GEO) ist kein Keyword-Trick. Es ist eine einfache Frage: Kann ein KI-System eine stabile, zitierfähige, maschinenlesbare Aussage über Ihr Produkt finden, ohne raten zu müssen? Die meisten SaaS-Seiten scheitern an diesem Test nicht, weil ihnen Inhalte fehlen, sondern weil ihre Inhalte für Menschen geschrieben sind, die scrollen, und die Flächen ignorieren, die ein Crawler tatsächlich parsen kann.
Dieser Artikel ist die maschinenlesbare Schicht, die wir mit Uncorne ausliefern. Er ist geschrieben, damit Sie die Struktur kopieren, nicht damit Sie sie bewundern.
Die Lesereihenfolge, der ein Agent folgt
Ein Agent mit begrenztem Kontextfenster liest nicht Ihre ganze Website. Er liest eine Handvoll kuratierter Flächen in einer vorhersehbaren Reihenfolge. Gestalten Sie für diese Reihenfolge.
llms.txt— ein kurzer, kuratierter Überblick mit Links, geschrieben für ein Modell, das nur wenige Tausend Tokens halten kann.llms-full.txt— die Detailfacts: vollständige Konfigurations-Enums, Bereinigungsregeln, die öffentliche API-Oberfläche und ehrliche Grenzen.- OpenAPI 3.1 — exakte Request- und Response-Schemata für jede öffentliche Route.
- Ein MCP-Endpunkt — ein zustandsloses JSON-RPC-Tool, das ein Agent aufrufen kann, um die aktuelle Konfiguration zu holen und sogar einen Build auszulösen.
- JSON-LD pro Seite — Organization, WebSite, SoftwareApplication / OfferCatalog, FAQPage und BlogPosting.
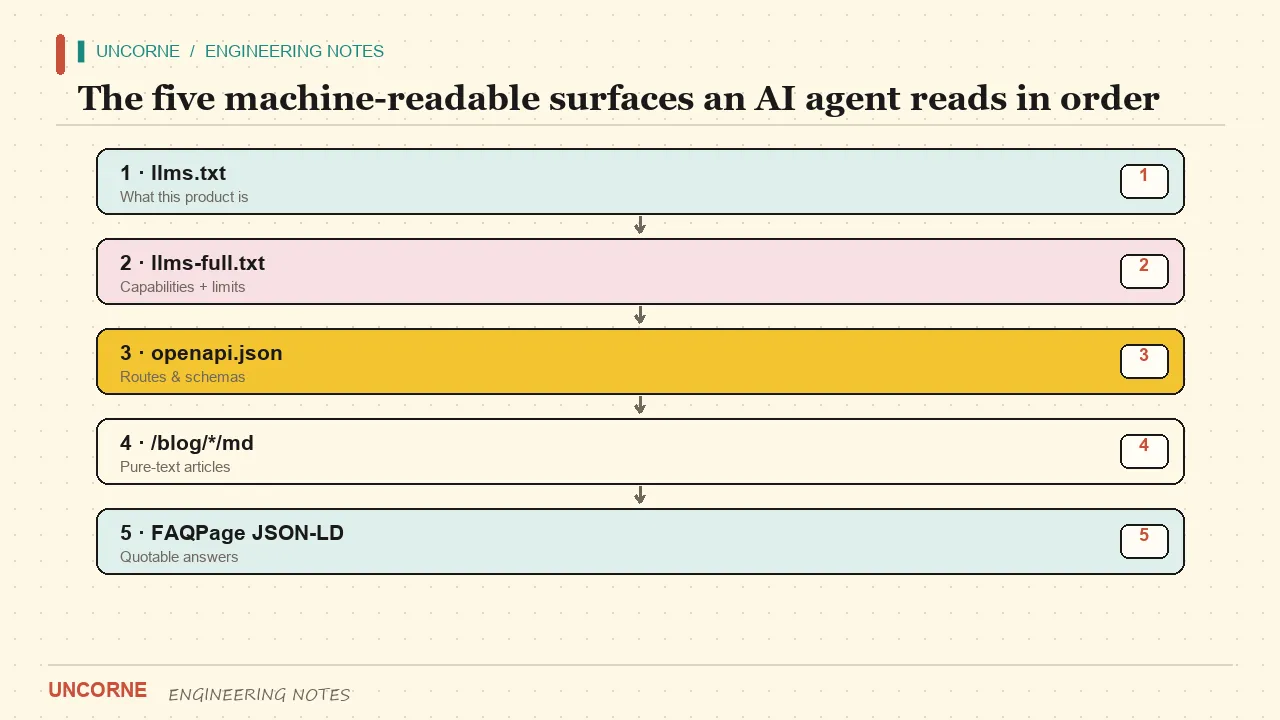
Die llms.txt-Spezifikation ist bewusst winzig: eine Markdown-Datei mit einer H1, einer kurzen Zusammenfassung und nach Zweck gruppierten Linklisten. Verstecken Sie sie nicht hinter einer JavaScript-gerenderten Seite. Liefern Sie sie als Klartext im Wurzelverzeichnis aus.
llms.txt versus llms-full.txt
Behandeln Sie llms.txt als ein Inhaltsverzeichnis mit Überzeugung. Jeder Link sollte die Frage beantworten: „Warum braucht ein Modell das?" Wenn eine Seite einem Agenten nicht hilft, eine Frage über Ihr Produkt zu beantworten, gehört sie nicht dorthin. llms-full.txt ist das Gegenteil: Es trägt die Fakten, die sonst über ein Dutzend Dokumentationsseiten verteilt wären — die vollständige Liste der Umgebungsvariablen, die exakten Bereinigungsregeln, was passiert, wenn ein Konfigurationsschlüssel fehlt.
Eine praktische Regel, die wir befolgen: Wenn sich ein Fact ändert, sobald sich der Code ändert, gehört er in llms-full.txt und wird aus derselben Wahrheitsquelle wie der Code generiert. So vermeiden Sie den klassischen GEO-Fehler — eine maschinenlesbare Datei, die selbstbewusst etwas behauptet, was das Produkt vor sechs Monaten längst nicht mehr tut.
OpenAPI 3.1 ist Ihr Vertrag, keine Dokumentation
Ein Agent, der mit Ihrem Produkt integrieren will, braucht exakte Schemata, keine prosaische Beschreibung der Endpunkte. Die OpenAPI-3.1-Spezifikation gibt Ihnen einen maschinenlesbaren Vertrag: Request-Bodies, Response-Formen, Statuscodes und Beispiele, alles in einer Datei. Veröffentlichen Sie sie unter einer stabilen URL und verlinken Sie sie von llms.txt aus.
Für einen SaaS-Starter sind die Routen dokumentationswürdig, die ein Agent tatsächlich aufrufen würde: eine Checkout-Session erstellen, ein Abonnement lesen, einen Webhook verifizieren. Dokumentieren Sie auch die Fehler-Responses. Ein Agent, der Ihre 402-Form kennt, kann einen Zahlungsfehler verarbeiten, ohne ihn zu erfinden.
openapi: 3.1.0
info:
  title: Uncorne API
  version: "1.0.0"
paths:
  /api/checkout:
    post:
      summary: Create a hosted checkout session
      responses:
        "200":
          description: Checkout URL
        "402":
          description: No price id configured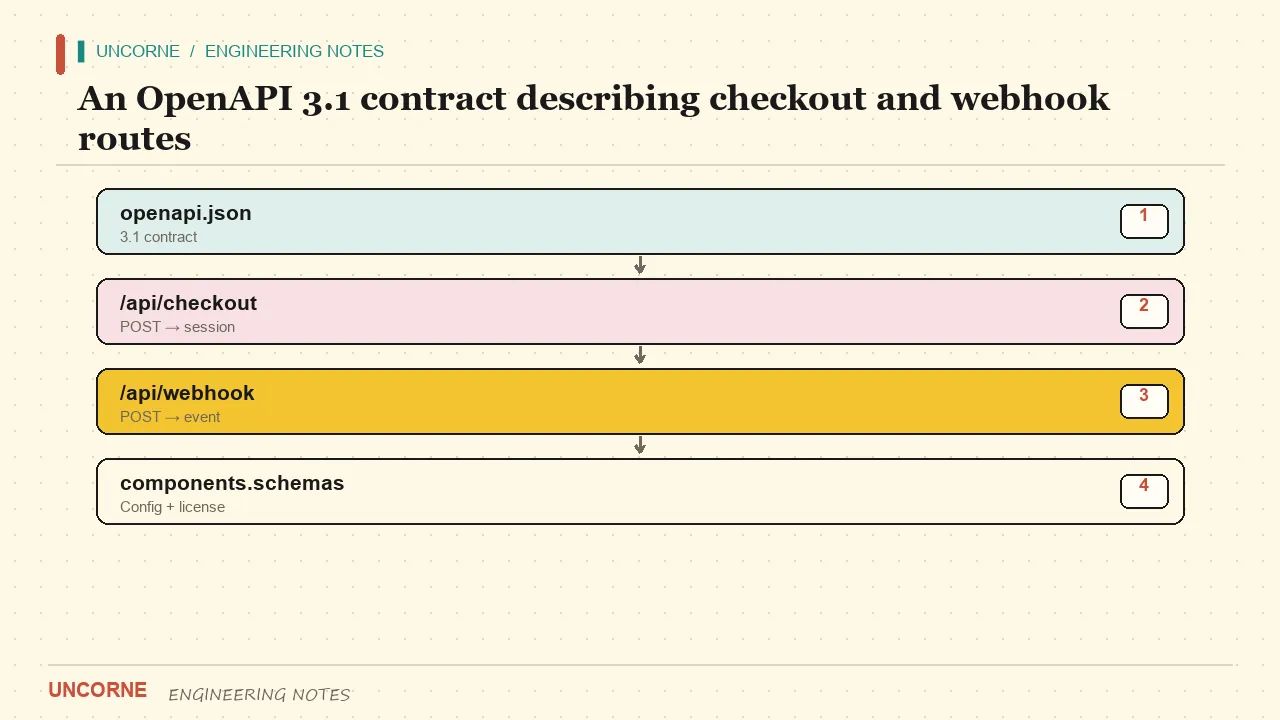
Der MCP-Endpunkt
Das Model Context Protocol ist das nächste, was es zu einem Standard für Agenten gibt, Ihr Produkt als Werkzeug aufzurufen. Ein kleiner zustandsloser JSON-RPC-Endpunkt, der die aktuelle Konfiguration zurückgibt, reicht zum Start. Die wichtige Eigenschaft ist Determinismus: Der gleiche Aufruf sollte die gleiche strukturierte Antwort liefern, keinen Absatz, der sich mit Ihrem Marketingtext ändert.
Wenn Sie ein MCP-Tool anbieten, das einen Build oder ein Projektgerüst auslösen kann, beschränken Sie es streng und verlangen Sie ein explizites Token. Ein Agent, der Ihre Konfiguration lesen kann, ist nützlich; ein Agent, der Ihre Produktion verändern kann, ist eine Haftung.
Strukturierte Daten auf jeder Seite
JSON-LD pro Seite ist dort, wo Antwort-Engines die zitierfähigen Einheiten erhalten, die sie bevorzugen. Der Typ schema.org BlogPosting verrät einem Crawler, wer einen Artikel geschrieben hat, wann er veröffentlicht und wann er zuletzt aktualisiert wurde. Der Typ schema.org FAQPage macht Frage-Antwort-Paare zugänglich — die in Antwort-Engines am häufigsten zitierte Struktur. Der Leitfaden für strukturierte Daten von Google ist die Referenz dafür, was Rich Results verdient und was ignoriert wird.
Byline und Publisher sollten das Unternehmen Uncorne sein, keine erfundene Person. Daten, kanonische URLs, inLanguage und keywords sollten explizit sein. Veröffentlicht am 2026-11-07, zuletzt geprüft am 2026-11-19 — ein Crawler sollte nie raten müssen, was neuer ist.
robots.txt und die Sitemap
Eine maschinenlesbare Fläche, die niemand finden kann, ist nutzlos. Erlauben Sie KI-Crawler in robots.txt und listen Sie die maschinenlesbaren Routen in Ihrer Sitemap auf. Viele Teams blockieren ihr eigenes llms.txt mit einer unbedachten Wildcard-Regel. Prüfen Sie das explizit.
Was in das heruntergeladene ZIP gehört
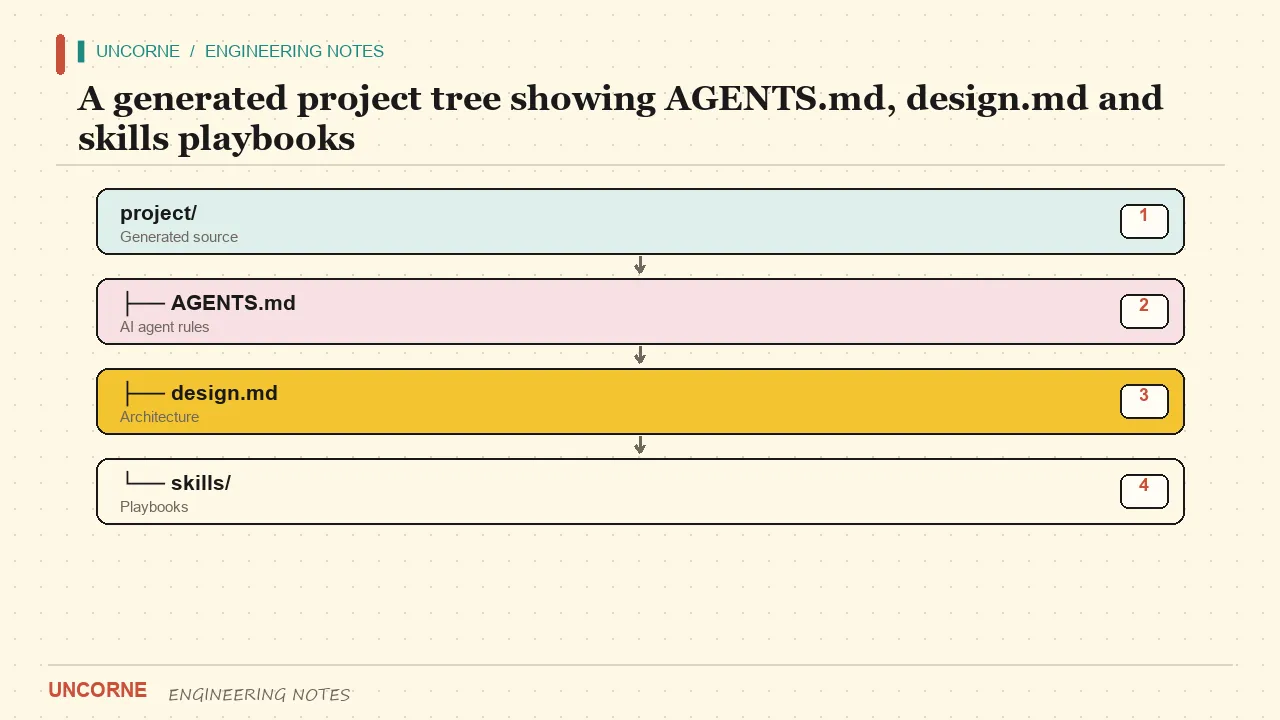
Das ist der Unterschied, den die meisten GEO-Ratschläge übersehen. Das llms.txt und der MCP-Endpunkt Ihrer Website sind seitenexklusiv; sie dürfen nicht in den Code eines Kunden durchsickern. Das generierte Projekt erhält sein eigenes AGENTS.md — den Repository-Vertrag und die Definition of Done — ein stilfestlegendes design.md, zielgerichtete Regeln mit Globs, Cursor-Regeln, CLAUDE.md und bis zu achtzehn Skills-Playbooks. Alles wird aus einer gemeinsamen Spezifikation gerendert, kann also nicht von shipkit.config.json abweichen, und ein blockierendes agents-lint-Gate in der GitHub-Actions-CI hält es ehrlich.
Ehrliche Grenzen sind GEO-Vermögenswerte
Vague Behauptungen werden ignoriert; konkrete Grenzen werden zitiert. Sagen Sie klar, dass SMTP nicht implementiert ist, dass der lokale Auth-Pfad kein MFA oder OAuth hat, dass MAIL_PROVIDER standardmäßig none ist, dass die externe Fehler-Senkung optional ist, dass das Cloudflare-Ziel Supabase braucht, weil node:sqlite auf Workers keine beschreibbare Festplatte hat, und dass das Rückerstattungsfenster schlicht 14 Tage beträgt — Zustellungsereignisse sind Beweise, keine Bedingung. Eine maschinenlesbare Grenze ist vertrauenswürdiger als ein Absatz voller Adjektive. Und sie muss in dem Moment aktualisiert werden, in dem sich der Code ändert.
Strukturierte Inhalte, kein Keyword-Stuffing
Jeder Artikel hier hat einen sichtbaren FAQ-Bereich, der aus denselben strukturierten Q&A-Daten gebaut ist, die auch sein FAQPage-JSON-LD erzeugen, plus eine Markdown-Variante, damit ein Crawler den Text ohne Rendern der Seite lesen kann. Das ist die ganze Strategie: die Wahrheit leicht zitierbar machen.
Wie man es misst
Keyword-Volumen ist die falsche Metrik für GEO. Verfolgen Sie in der Analyse den KI-Referral-Traffic — chatgpt.com, perplexity.ai, gemini.google.com — Marken-Erwähnungen und Share of Voice in KI-Antworten, und ob die zitierte URL eine der oben genannten maschinenlesbaren Flächen ist. Mehr lesen Sie in unserem Vergleich der SaaS-Zahlungsgateways und im Leitfaden zu Abrechnungs-Gateways, die denselben Ansatz ehrlicher Grenzen verfolgen. Wenn eine Antwort-Engine Sie nicht zitieren kann, helfen zusätzliche Landingpages nicht weiter.
Ein Frischevertrag, kein einmaliges Schreiben
Der teuerste GEO-Fehler ist eine maschinenlesbare Datei, die falsch wird. Integrieren Sie die Erzeugung von llms.txt, llms-full.txt und des OpenAPI-Dokuments in Ihre Build-Pipeline, damit eine Konfigurationsänderung sie im selben Commit neu schreibt. Fügen Sie eine CI-Prüfung hinzu, die fehlschlägt, wenn eine dokumentierte Enumeration im Code nicht mehr existiert. Ein Agent, der eine veraltete Fähigkeit zitiert, stellt Ihr Produkt falsch dar — und entgegen der üblichen Empfehlung ist es besser, weniger Fakten zu veröffentlichen, die wahr bleiben, als mehr Fakten, die abwandern.
Der Zitat-Test
Bevor Sie eine neue maschinenlesbare Fläche veröffentlichen, stellen Sie eine Frage: Wenn eine Antwort-Engine genau diesen Satz aufgreifen und unter Ihrer Marke abdrucken würde, wären Sie damit einverstanden? Ist der Satz eine Behauptung, die Sie in einem Support-Ticket nicht verteidigen können, gehört er nicht in eine maschinenlesbare Datei. Deshalb ist die obige Grenzenliste länger als die Funktionsliste in den meisten unserer Dokus.
FAQ
Was ist der Unterschied zwischen llms.txt und llms-full.txt?+
llms.txt ist ein kurzer, kuratierter Überblick mit Links für ein begrenztes Kontextfenster; llms-full.txt enthält die Detailfacts wie Konfigurations-Enums, API-Schemata, Bereinigungsregeln und ehrliche Grenzen.
Enthalten generierte Kundenprojekte unser llms.txt und den MCP-Endpunkt?+
Nein. Beide sind nur für die Website und werden aus jedem Kunden-ZIP entfernt. Das generierte Projekt enthält stattdessen ein eigenes AGENTS.md, design.md, zielgerichtete Regeln, Cursor-Regeln, CLAUDE.md und Skills-Playbooks.
Wie misst man GEO statt Keyword-Volumen?+
Verfolgen Sie KI-Referral-Traffic (chatgpt.com, perplexity.ai, gemini.google.com), Marken-Erwähnungen und Share of Voice in KI-Antworten, und ob die zitierte URL eine maschinenlesbare Fläche wie ein FAQ oder eine Markdown-Variante ist.
Wo sollten Webhook- und Checkout-Routen dokumentiert werden?+
In einer OpenAPI-3.1-Datei unter einer stabilen URL, verlinkt von llms.txt. Ein integrierender Agent braucht exakte Request- und Response-Schemata — einschließlich Fehlern wie 402 — keine Prosa-Beschreibungen.