Docs SaaS prêtes pour les agents : les fichiers que l'IA lit

L'optimisation pour les moteurs génératifs (GEO) n'est pas une astuce de mots-clés. C'est une question simple : un système d'IA peut-il trouver une déclaration stable, citables et lisible par machine à propos de votre produit, sans rien deviner ? La plupart des sites SaaS échouent à ce test non pas parce qu'ils manquent de contenu, mais parce que leur contenu est écrit pour des humains qui défilent et ignore les surfaces qu'un crawler peut réellement analyser.
Cet article est la couche lisible par machine que nous livrons avec Uncorne. Il est écrit pour que vous copiiez la structure, pas pour que vous l'admiriez.
L'ordre de lecture suivi par un agent
Un agent dont la fenêtre de contexte est limitée ne lit pas tout votre site. Il lit une poignée de surfaces choisies dans un ordre prévisible. Concevez pour cet ordre.
llms.txt— une courte vue d'ensemble choisie, avec des liens, écrite pour un modèle qui ne peut retenir que quelques milliers de jetons.llms-full.txt— les faits détaillés : énumérations complètes de configuration, règles d'élagage, surface API publique et limites honnêtes.- OpenAPI 3.1 — schémas exacts de requête et de réponse pour chaque route publique.
- Un point d'accès MCP — un outil JSON-RPC sans état qu'un agent peut appeler pour obtenir la configuration actuelle, et même déclencher un build.
- Le JSON-LD par page — Organization, WebSite, SoftwareApplication / OfferCatalog, FAQPage et BlogPosting.
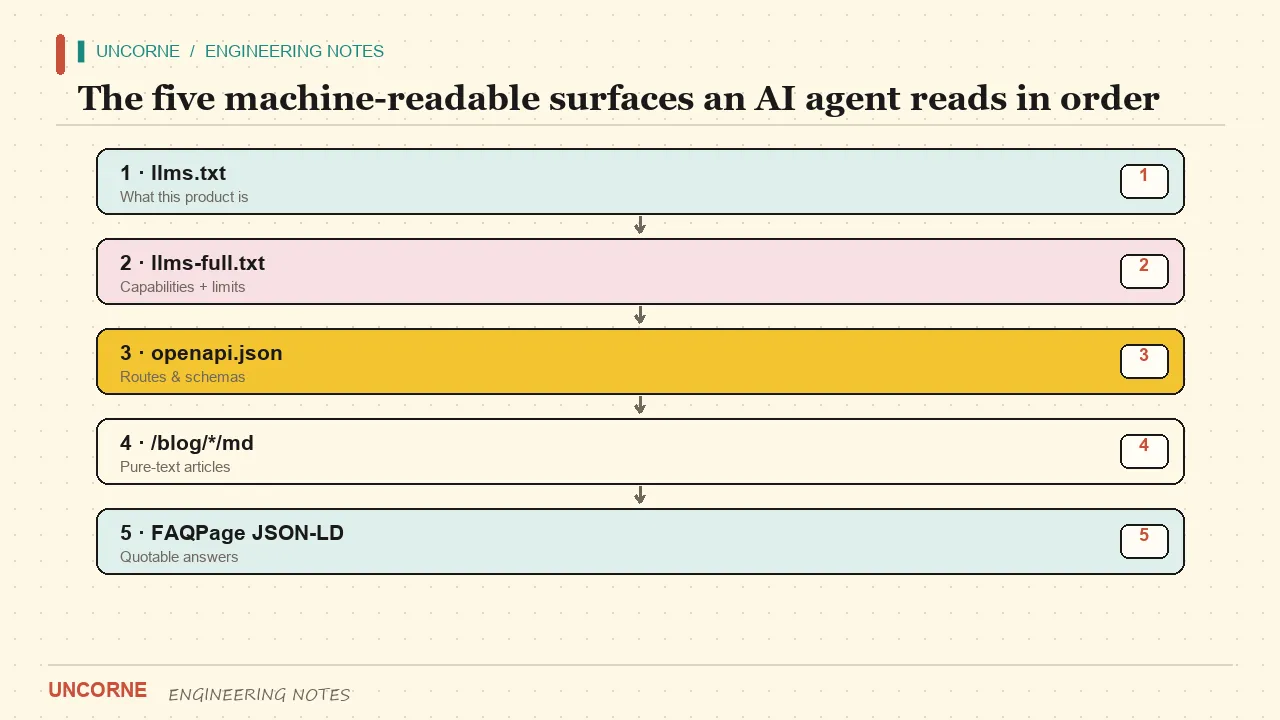
La spécification llms.txt est délibérément minuscule : un fichier Markdown avec un H1, un court résumé et des listes de liens regroupés par usage. Ne l'enterrez pas derrière une page rendue par JavaScript. Serviez-le en texte brut à la racine.
llms.txt contre llms-full.txt
Traitez llms.txt comme une table des matières avec conviction. Chaque lien doit répondre à « pourquoi un modèle aurait-il besoin de ceci ? » Si une page n'aide pas un agent à répondre à une question sur votre produit, elle n'a pas sa place ici. llms-full.txt est l'inverse : il porte les faits qui seraient sinon éparpillés sur une douzaine de pages de documentation — la liste complète des variables d'environnement, les règles d'élagage exactes, ce qui se passe quand une clé de configuration manque.
Une règle pratique que nous suivons : si un fait change quand le code change, il vit dans llms-full.txt et est généré depuis la même source de vérité que le code. C'est ainsi que vous évitez l'échec classique du GEO — un fichier lisible par machine qui affirme avec assurance quelque chose que le produit a cessé de faire il y a six mois.
OpenAPI 3.1 est votre contrat, pas une documentation
Un agent qui veut s'intégrer à votre produit a besoin de schémas exacts, pas d'une description en prose des points d'accès. La spécification OpenAPI 3.1 vous donne un contrat lisible par machine : corps de requête, formes de réponse, codes de statut et exemples, le tout dans un seul fichier. Publiez-le à une URL stable et liez-le depuis llms.txt.
Pour un starter SaaS, les routes qui méritent d'être documentées sont celles qu'un agent appellera réellement : créer une session de paiement, lire un abonnement, vérifier un webhook. Documentez aussi les réponses d'erreur. Un agent qui connaît la forme de votre 402 peut gérer un échec de paiement sans l'inventer.
openapi: 3.1.0
info:
  title: Uncorne API
  version: "1.0.0"
paths:
  /api/checkout:
    post:
      summary: Create a hosted checkout session
      responses:
        "200":
          description: Checkout URL
        "402":
          description: No price id configured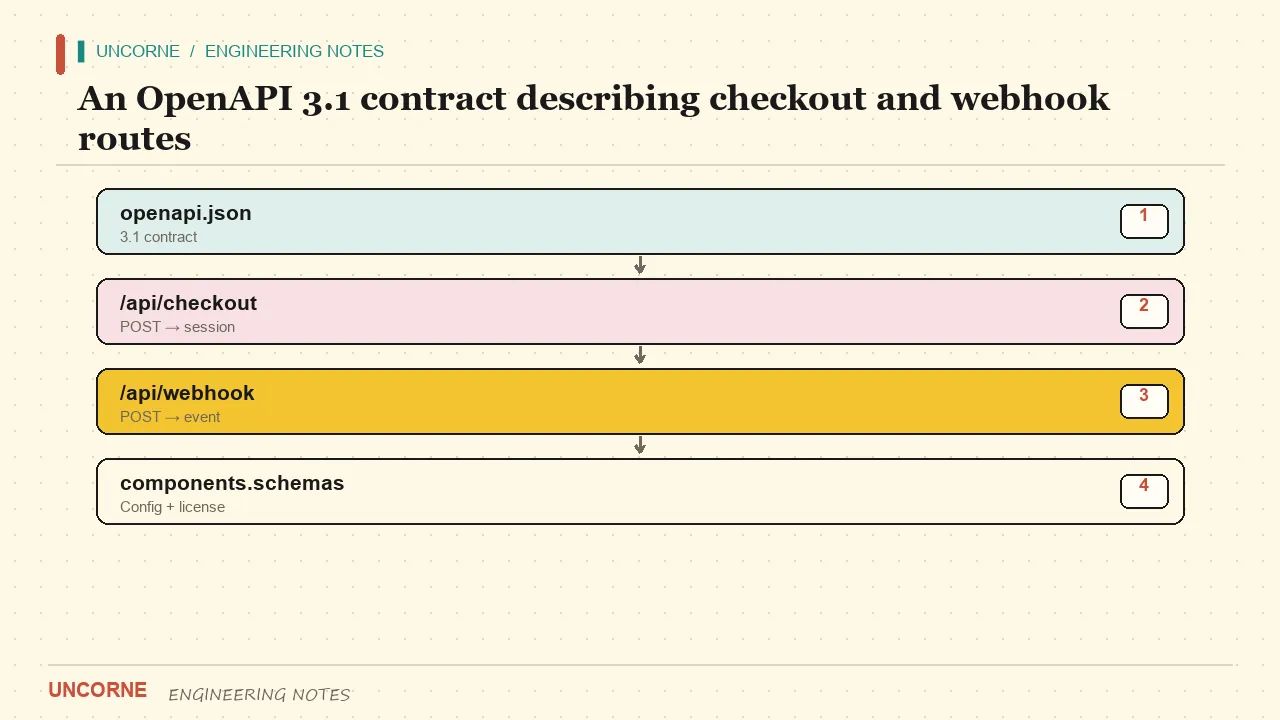
Le point d'accès MCP
Le Model Context Protocol est ce qui ressemble le plus à une façon standard pour un agent d'appeler votre produit comme outil. Un petit point d'accès JSON-RPC sans état qui renvoie la configuration actuelle suffit pour commencer. La propriété importante est la déterminisme : le même appel doit renvoyer la même réponse structurée, pas un paragraphe qui change avec votre texte marketing.
Si vous exposez un outil MCP capable de déclencher un build ou de générer un projet, limitez-le strictement et exigez un jeton explicite. Un agent qui peut lire votre configuration est utile ; un agent qui peut modifier votre production est un passif.
Des données structurées sur chaque page
Le JSON-LD par page est là où les moteurs de réponse obtiennent les unités citables qu'ils préfèrent. Le type schema.org BlogPosting indique à un crawler qui a écrit un article, quand il a été publié et quand il a été mis à jour. Le type schema.org FAQPage expose des paires question-réponse — la structure la plus citée dans les moteurs de réponse. Le guide des données structurées de Google est la référence sur ce qui mérite des résultats enrichis et ce qui est ignoré.
La signature et l'éditeur doivent être l'entreprise, Uncorne, et non une personne inventée. Les dates, les URL canoniques, inLanguage et keywords doivent être explicites. Publié le 2026-11-07, dernière révision le 2026-11-19 — un crawler ne doit jamais avoir à deviner lequel est le plus récent.
robots.txt et le sitemap
Une surface lisible par machine que personne ne peut trouver est inutile. Autorisez les crawlers d'IA dans robots.txt et listez les routes lisibles par machine dans votre sitemap. De nombreuses équipes bloquent leur propre llms.txt avec une règle joker négligente. Vérifiez-le explicitement.
Ce qui doit figurer dans le ZIP téléchargé
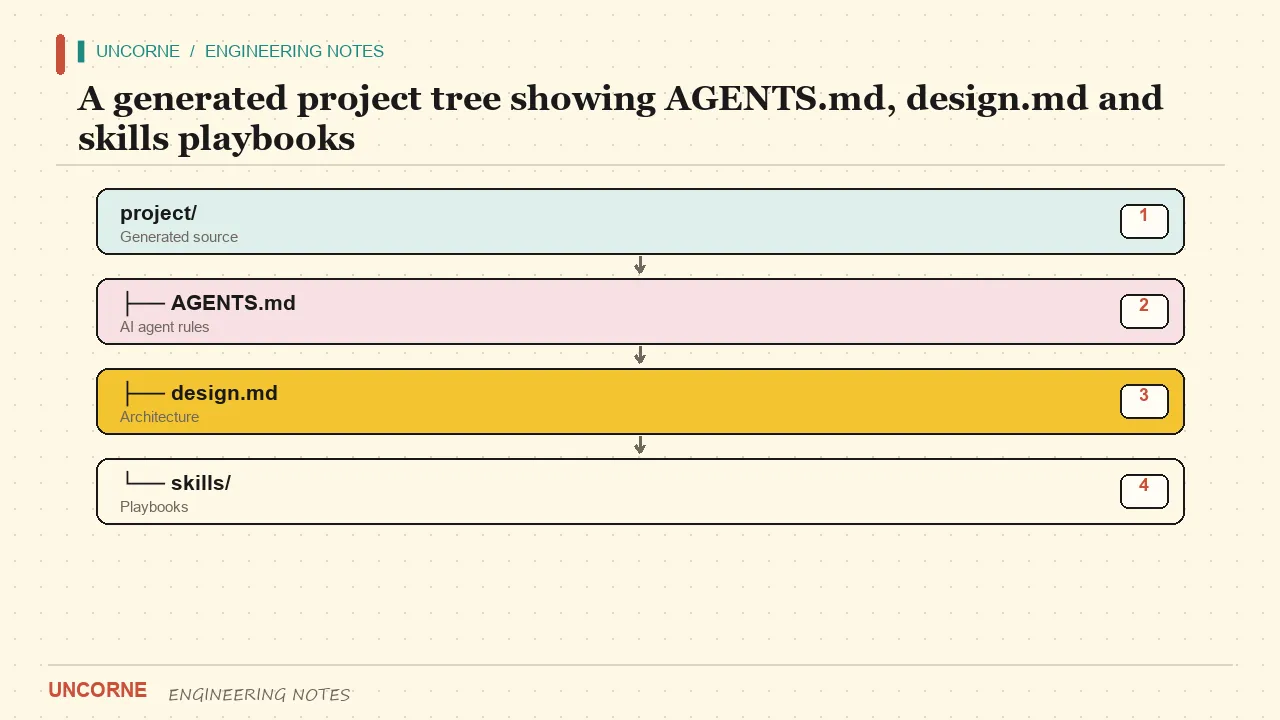
C'est la distinction que la plupart des conseils GEO manquent. Le llms.txt et le point d'accès MCP de votre site sont réservés au site ; ils ne doivent pas fuir dans le code qu'un client télécharge. Le projet généré reçoit son propre AGENTS.md — le contrat du dépôt et la définition de « terminé » — un design.md fixant le style, des règles ciblées avec globs, des règles Cursor, CLAUDE.md, et jusqu'à dix-huit playbooks de compétences. Tout est rendu depuis une seule spécification, donc cela ne peut pas dériver de shipkit.config.json, et un garde agents-lint bloquant dans la CI GitHub Actions le maintient honnête.
Les limites honnêtes sont des atouts GEO
Les affirmations vagues sont ignorées ; les limites précises sont citées. Dites clairement que SMTP n'est pas implémenté, que le parcours d'authentification local n'a ni MFA ni OAuth, que MAIL_PROVIDER vaut none par défaut, que le récepteur d'erreurs externe est optionnel, que la cible Cloudflare nécessite Supabase parce que node:sqlite n'a pas de disque inscriptible sur Workers, et que la fenêtre de remboursement est simplement de 14 jours — les événements de livraison sont une preuve, pas une condition. Une limite lisible par machine est plus fiable qu'un paragraphe d'adjectifs. Et elle doit être mise à jour dès que le code change.
Du contenu structuré, pas du bourrage de mots-clés
Chaque article ici comporte une section FAQ visible, construite à partir des mêmes données Q&R structurées qui produisent son JSON-LD FAQPage, plus une variante Markdown afin qu'un crawler puisse lire le texte sans rendre la page. Toute la stratégie tient là : rendre la vérité facile à citer.
Comment mesurer le résultat
Le volume de mots-clés est la mauvaise métrique pour le GEO. Suivez le trafic de référence IA dans vos analyses — chatgpt.com, perplexity.ai, gemini.google.com — les mentions de marque et la part de voix dans les réponses IA, et si l'URL citée est l'une des surfaces lisibles par machine ci-dessus. Vous pouvez en lire davantage dans notre comparatif des passerelles de paiement SaaS et le guide des passerelles de facturation, qui suivent la même approche de limites honnêtes. Si un moteur de réponse ne peut pas vous citer, ajouter des pages d'atterrissage n'y changera rien.
Un contrat de fraîcheur, pas une écriture unique
L'échec GEO le plus coûteux est un fichier lisible par machine qui devient faux. Mettez la génération de llms.txt, llms-full.txt et du document OpenAPI dans votre pipeline de build, afin qu'un changement de configuration les réécrive dans le même commit. Ajoutez un contrôle CI qui échoue lorsqu'une énumération documentée n'existe plus dans le code. Un agent qui cite une capacité obsolète présentera mal votre produit — et, contrairement aux conseils habituels, mieux vaut publier moins de faits qui restent vrais que davantage de faits qui dérivent.
Le test de citation
Avant de publier une nouvelle surface lisible par machine, posez une question : si un moteur de réponse reprenait cette phrase exacte et l'imprimait sous votre marque, seriez-vous à l'aise ? Si la phrase est une affirmation que vous ne pouvez pas défendre dans un ticket de support, elle n'a pas sa place dans un fichier lisible par machine. C'est pourquoi la liste de limites ci-dessus est plus longue que la liste de fonctionnalités de la plupart de nos docs.
FAQ
Quelle est la différence entre llms.txt et llms-full.txt ?+
llms.txt est une courte vue d'ensemble choisie avec des liens, pour une fenêtre de contexte limitée ; llms-full.txt porte les faits détaillés : énumérations de configuration, schémas API, règles d'élagage et limites honnêtes.
Les projets clients générés contiennent-ils notre llms.txt et notre point d'accès MCP ?+
Non. Ils sont réservés au site et élagués de chaque ZIP client. Le projet généré contient plutôt son propre AGENTS.md, design.md, règles ciblées, règles Cursor, CLAUDE.md et playbooks de compétences.
Comment mesurer le GEO plutôt que le volume de mots-clés ?+
Suivez le trafic de référence IA (chatgpt.com, perplexity.ai, gemini.google.com), les mentions de marque et la part de voix dans les réponses IA, et si l'URL citée est une surface lisible par machine comme un FAQ ou une variante Markdown.
Où documenter les routes de webhook et de paiement ?+
Dans un fichier OpenAPI 3.1 à une URL stable, lié depuis llms.txt. Un agent qui s'intègre a besoin de schémas exacts de requête et de réponse — y compris les erreurs comme un 402 — et non de descriptions en prose.
Toutes les questions fréquentes · Version Markdown (pour les agents IA)