Agent-Ready SaaS ドキュメント:AI エージェントが実際に読むファイル

生成エンジン最適化(GEO)はキーワードの小手先の技ではありません。それは単純な問いです。AI システムは、推測することなく、あなたの製品について安定して引用可能な機械可読の記述を見つけられるか? ほとんどの SaaS サイトがこの試験に落ちるのは、コンテンツが足りないからではなく、コンテンツがスクロールして読む人間のために書かれ、クローラーが実際に解析できる面が無視されているからです。
この記事は Uncorne が製品とともに提供する機械可読レイヤーです。眺めてもらうためではなく、構造をそのまま写してもらえるように書いています。
エージェントがたどる読み取り順
コンテキストウィンドウが限られたエージェントは、サイト全体を読みません。予測可能な順番で、厳選されたいくつかの面を読みます。その順番に合わせて設計してください。
llms.txt— 数千トークンしか保持できないモデル向けに書かれた、リンク付きの短い精選概要。llms-full.txt— 長文の事実:完全な設定列挙、剪定ルール、公開 API の表面、そして正直な限界。- OpenAPI 3.1 — すべての公開ルートに対する正確なリクエスト/レスポンススキーマ。
- MCP 端点 — エージェントが呼び出して現在の設定を取得し、ビルドさえも起動できるステートレスな JSON-RPC ツール。
- ページ単位の JSON-LD — Organization、WebSite、SoftwareApplication/OfferCatalog、FAQPage、BlogPosting。
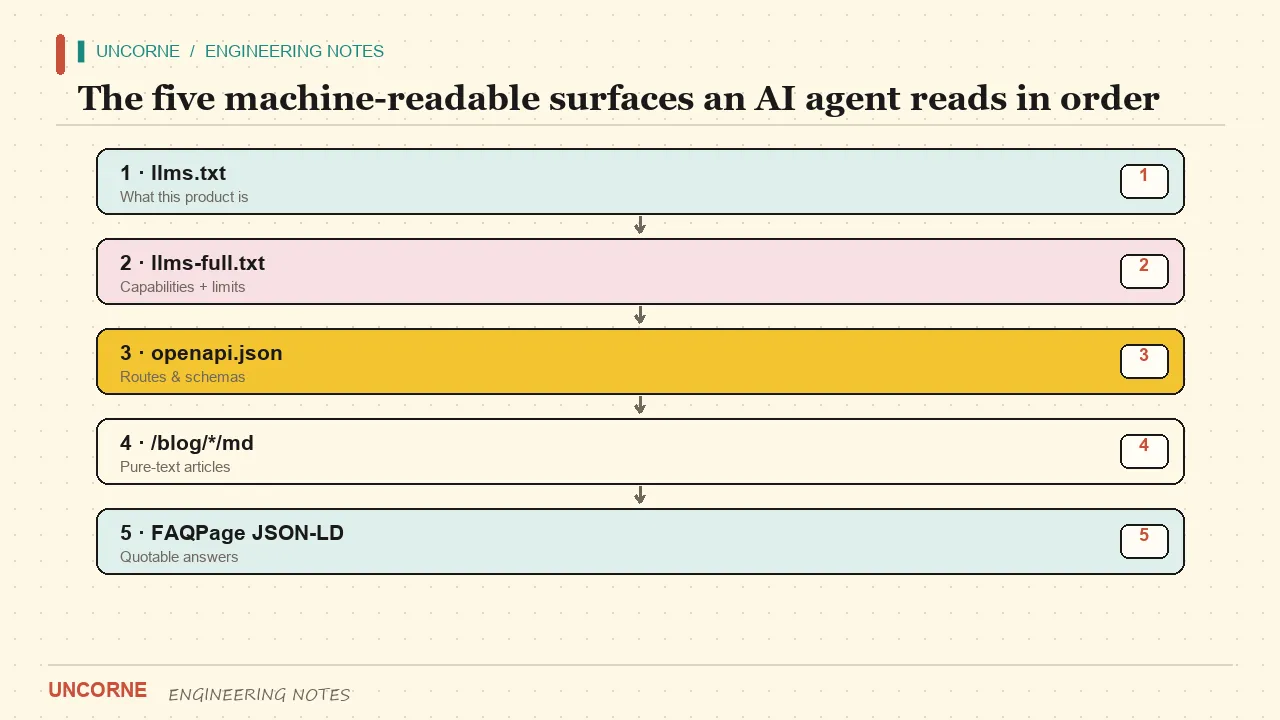
llms.txt 仕様は意図的に小さく作られています。H1、短い要約、目的ごとにグループ化したリンク一覧を持つ Markdown ファイルです。JavaScript で描画されるページの裏に隠さないでください。ルートパスでプレーンテキストとして配信します。
llms.txt と llms-full.txt の違い
llms.txt は、確信を持って書かれた目次だと考えてください。すべてのリンクが「なぜモデルにこれが必要なのか?」に答えるべきです。ページがエージェントの製品に関する質問の役に立たないなら、そこに置くべきではありません。llms-full.txt はその逆で、十数個のドキュメントページに散らばるはずの事実——環境変数の完全な一覧、正確な剪定ルール、設定キーが欠けたときに何が起きるか——を運びます。
私たちが守る実用的な規則があります。コードが変われば事実も変わるなら、それは llms-full.txt に置き、コードと同じ単一の情報源から生成します。こうすれば典型的な GEO の失敗——機械可読ファイルが、製品が半年前にやめたことを今も自信満々に述べる——を避けられます。
OpenAPI 3.1 はドキュメントではなく契約
製品と連携したいエージェントには、端点の散文的な説明ではなく、正確なスキーマが必要です。OpenAPI 3.1 仕様は、リクエストボディ、レスポンス形状、ステータスコード、例をすべて 1 ファイルにまとめた機械可読の契約を与えます。安定した URL で公開し、llms.txt からリンクしてください。
SaaS スターターでは、ドキュメントに載せる価値のあるルートは、エージェントが実際に呼ぶものです。チェックアウトセッションの作成、サブスクリプションの読み取り、Webhook の検証。エラーレスポンスも書いてください。あなたの 402 の形状を知るエージェントなら、でっち上げることなく支払い失敗を処理できます。
openapi: 3.1.0
info:
  title: Uncorne API
  version: "1.0.0"
paths:
  /api/checkout:
    post:
      summary: Create a hosted checkout session
      responses:
        "200":
          description: Checkout URL
        "402":
          description: No price id configured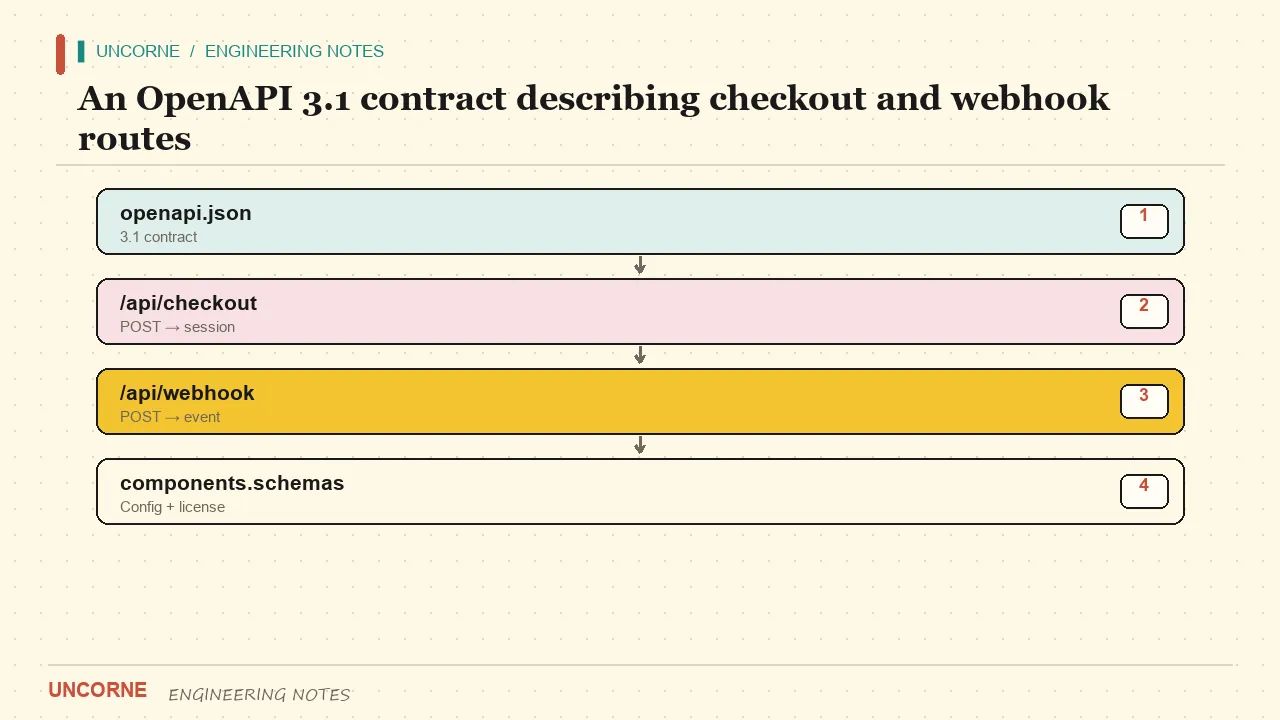
MCP 端点
Model Context Protocol は、エージェントがあなたの製品をツールとして呼び出すための、最も標準に近い方法です。現在の設定を返す小さなステートレス JSON-RPC 端点があれば始められます。重要な性質は決定性です。同じ呼び出しは、マーケティング文言で変わる段落ではなく、同じ構造化された答えを返すべきです。
ビルドやプロジェクトの雛形生成を起動できる MCP ツールを公開するなら、範囲を厳しく絞り、明示的なトークンを要求してください。設定を読めるエージェントは有用ですが、本番環境を変更できるエージェントは負債です。
すべてのページに構造化データ
ページ単位の JSON-LD は、回答エンジンが好む引用可能な単位を得る場所です。schema.org BlogPosting 型は、誰が記事を書き、いつ公開し、いつ更新したかをクローラーに伝えます。schema.org FAQPage 型は問答ペアを公開します——回答エンジンで最も引用される単一の構造です。Google の構造化データガイドは、何がリッチリザルトを得て、何が無視されるかの基準です。
署名と publisher は架空の人物ではなく、会社である Uncorne にすべきです。日付、canonical、inLanguage、keywords は明示してください。公開 2026-11-07、最終確認 2026-11-19——クローラーがどちらが新しいか推測する必要があってはなりません。
robots.txt と sitemap
誰も見つけられない機械可読面は無駄です。robots.txt で AI クローラーを許可し、sitemap に機械可読ルートを載せてください。多くのチームが不用意なワイルドカード規則で自分の llms.txt をブロックしています。明示的に確認しましょう。
ダウンロード ZIP に入れるべきもの
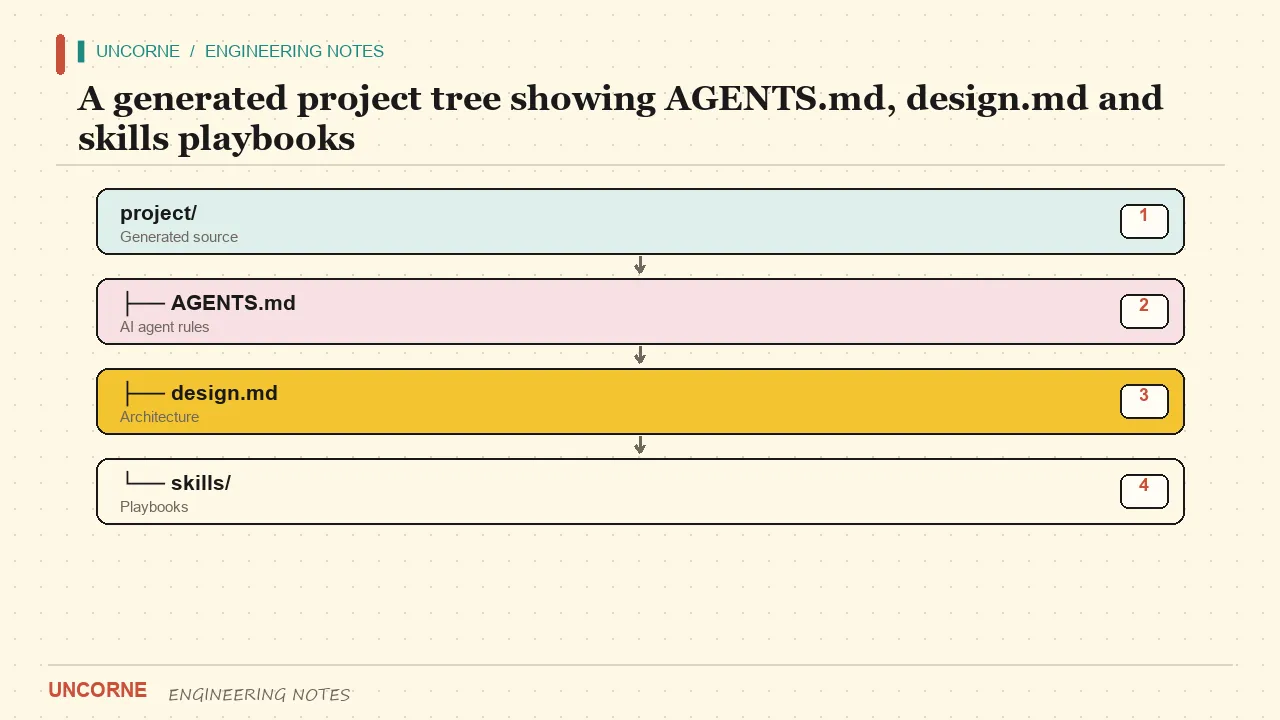
これは多くの GEO 助言が見落とす違いです。サイトの llms.txt と MCP 端点はサイト専用で、顧客がダウンロードするコードに漏れてはいけません。生成されたプロジェクトは、独自の AGENTS.md(リポジトリ契約と完了の定義)、スタイルを固定する design.md、glob 付きの scoped rules、Cursor rules、CLAUDE.md、そして最大 18 個の skills playbook を受け取ります。すべて単一の spec から描画されるため shipkit.config.json と乖離できず、GitHub Actions CI のブロッキングな agents-lint ガードが誠実さを保ちます。
正直な限界は GEO 資産
曖昧な主張は無視され、具体的な限界が引用されます。SMTP は未実装であること、ローカル認証経路に MFA と OAuth がないこと、MAIL_PROVIDER の既定値が none であること、外部エラーシンクは任意であること、Cloudflare ターゲットは Workers に書き込み可能なディスクがないため Supabase が必要であること、返金期間は純粋な 14 日であること(配信イベントは証拠であり条件ではない)を率直に述べてください。機械可読な限界は、形容詞の段落より信頼されます。そしてコードが変わった瞬間に更新しなければなりません。
構造化されたコンテンツであって、キーワード詰め込みではない
このサイトのすべての記事には、FAQPage JSON-LD を生成するのと同じ構造化 Q&A データから作られた目に見える FAQ セクションがあり、さらに Markdown 版も公開されているため、クローラーはページを描画せずに本文を読めます。これが戦略のすべてです。真実を引用しやすくすること。
測定方法
キーワード量は GEO の指標ではありません。アナリティクスの AI 参照トラフィック(chatgpt.com、perplexity.ai、gemini.google.com)、AI 回答でのブランドメンションと SOV、そして引用された URL が上記の機械可読面のいずれかであるかを追跡してください。詳しくは、同じ正直な限界のアプローチに従った SaaS 決済ゲートウェイ比較 と課金ゲートウェイガイドを読めます。回答エンジンがあなたを引用できないなら、ランディングページを増やしても直りません。
一度きりの記述ではなく、鮮度の契約
もっとも高くつく GEO の失敗は、機械可読ファイルが古くなることです。llms.txt、llms-full.txt、OpenAPI ドキュメントの生成をビルドパイプラインに組み込み、設定変更があれば同じコミットで書き換えられるようにします。ドキュメントに載っている列挙値がコードに存在しなくなったら失敗する CI チェックを追加してください。古い機能を引用するエージェントは製品を誤って紹介します。しかも一般的な助言とは逆に、変化していく多くの事実よりも、真であり続ける少ない事実を公開するほうがましです。
引用テスト
新しい機械可読面を公開する前に、一つの問いを投げてください。回答エンジンがこの文をそのまま抜き出し、あなたのブランド名で印刷したとき、違和感はないか? サポートチケットで弁護できない主張なら、その文は機械可読ファイルに置くべきではありません。だからこそ、上記の限界リストは私たちの多くのドキュメントの機能リストより長くなっています。
FAQ
llms.txt と llms-full.txt の違いは何ですか?+
llms.txt は限られたコンテキスト向けのリンク付き精選概要です。llms-full.txt は設定列挙、API スキーマ、剪定ルール、正直な限界といった長文の事実を運びます。
生成された顧客プロジェクトにサイトの llms.txt と MCP 端点は入りますか?+
いいえ。これらはサイト専用で、すべての顧客 ZIP から剪定されます。代わりに、生成プロジェクトは独自の AGENTS.md、design.md、scoped rules、Cursor rules、CLAUDE.md、skills playbook を搭載します。
キーワード量ではなく GEO は何を測るべきですか?+
AI 参照トラフィック(chatgpt.com、perplexity.ai、gemini.google.com)、AI 回答でのブランドメンションと SOV、そして引用 URL が FAQ や Markdown 版といった機械可読面かどうかを追跡します。
Webhook とチェックアウトのルートはどこに文書化すべきですか?+
安定した URL の OpenAPI 3.1 ファイルに記述し、llms.txt からリンクします。連携するエージェントには、散文ではなく、402 のようなエラーレスポンスを含む正確なリクエスト/レスポンススキーマが必要です。