Agent-Ready SaaS 文档:AI agent 真正会读的文件

生成式引擎优化(GEO)不是关键词技巧,而是一个简单的问题:AI 系统能否在不猜测的前提下,找到关于你产品的稳定、可引用、机器可读的陈述?大多数 SaaS 站点通不过这个测试,不是因为内容不够,而是因为内容是为会滚动阅读的人写的,忽略了爬虫真正能解析的那几个面。
这篇文章就是 Uncorne 随产品交付的机器可读层,写出来是让你照抄结构,而不是让你欣赏结构。
agent 遵循的读取顺序
上下文窗口有限的 agent 不会读你整个站点。它按可预测的顺序读少数几个精选面。要为这个顺序做设计。
llms.txt——给只能容纳几千 token 的模型看的精要概览与链接。llms-full.txt——长文事实:完整的配置枚举、裁剪规则、公开 API 面以及诚实的限制。- OpenAPI 3.1——每个公开路由精确的请求/响应 schema。
- MCP 端点——agent 可调用的无状态 JSON-RPC 工具,用于取当前配置,甚至触发构建。
- 页面级 JSON-LD——Organization、WebSite、SoftwareApplication/OfferCatalog、FAQPage 与 BlogPosting。
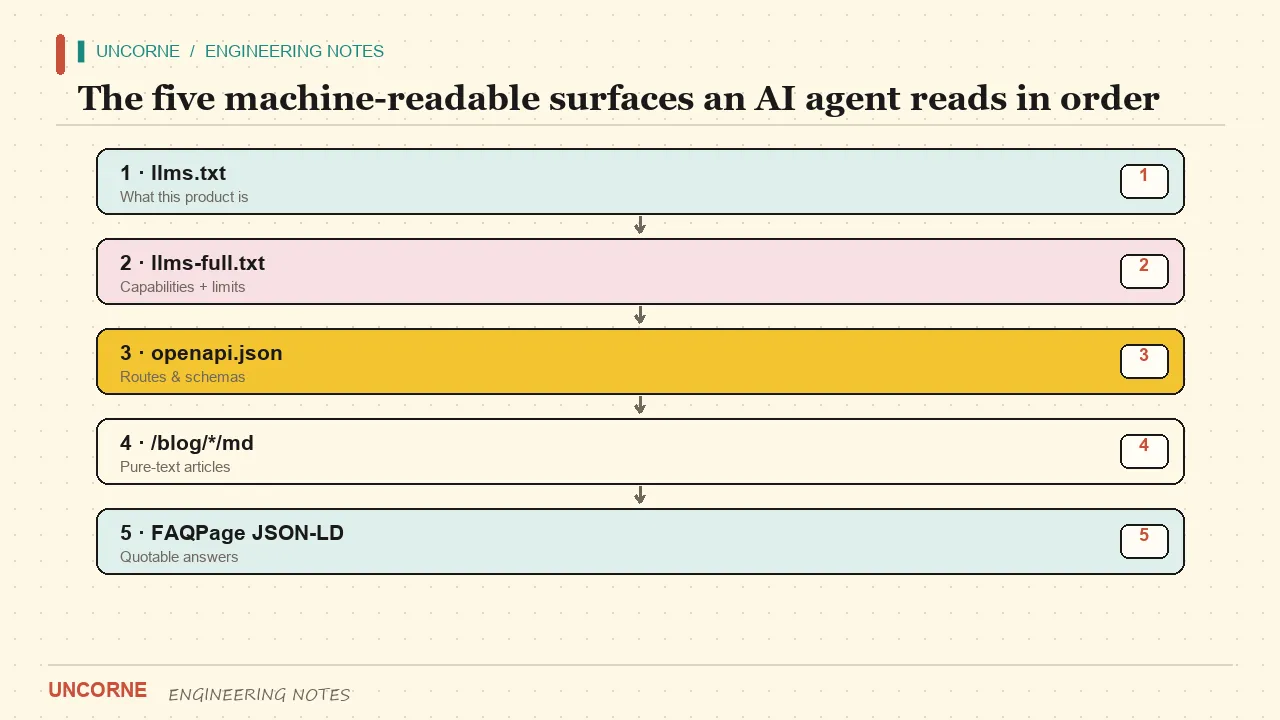
llms.txt 规范刻意做得很小:一个 Markdown 文件,包含 H1、简短摘要和按用途分组的链接列表。不要把它藏在 JavaScript 渲染的页面后面。用纯文本在根路径提供它。
llms.txt 与 llms-full.txt 的区别
把 llms.txt 当成一份有定力的目录。每个链接都应该回答「模型为什么需要这个?」如果某个页面不能帮 agent 回答关于你产品的问题,它就不该在这里。llms-full.txt 则相反:它承载那些本会散落在十几个文档页里的事实——完整的环境变量列表、精确的裁剪规则、配置键缺失时会发生什么。
我们遵循一条实用规则:如果某个事实会随代码变化而变化,它就放在 llms-full.txt 里,并由与代码相同的真值源生成。这样才能避免典型的 GEO 失败——一个机器可读文件,自信地陈述着产品半年前就不再做的事。
OpenAPI 3.1 是你的契约,不是文档
想与你产品集成的 agent 需要精确的 schema,而不是端点的散文式描述。OpenAPI 3.1 规范给你一份机器可读的契约:请求体、响应形状、状态码和示例,全在一个文件里。用稳定 URL 发布它,并从 llms.txt 链接过去。
对 SaaS starter 来说,值得写进文档的路由是 agent 真会调用的那些:创建结账会话、读取订阅、验证 Webhook。错误响应也要写。知道你 402 形状的 agent,才能在不臆造的情况下处理支付失败。
openapi: 3.1.0
info:
  title: Uncorne API
  version: "1.0.0"
paths:
  /api/checkout:
    post:
      summary: Create a hosted checkout session
      responses:
        "200":
          description: Checkout URL
        "402":
          description: No price id configured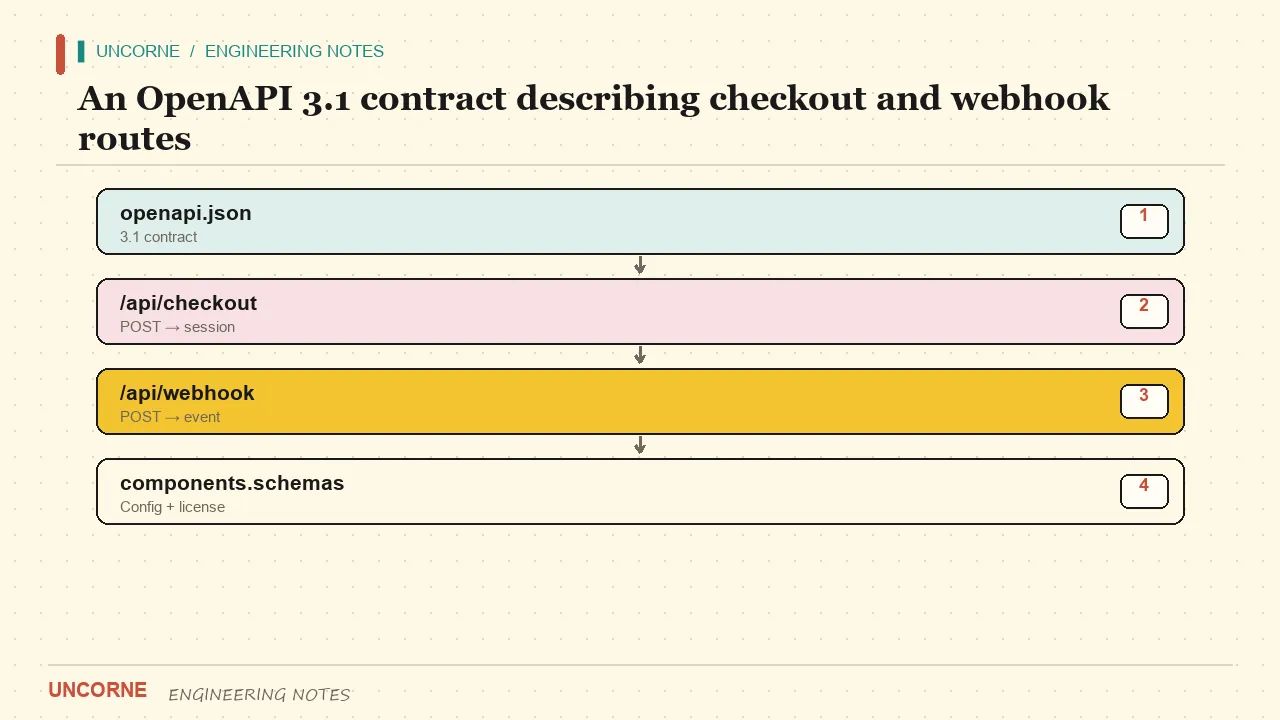
MCP 端点
Model Context Protocol 是最接近「agent 把你的产品当工具调用」的标准方式。一个返回当前配置的小型无状态 JSON-RPC 端点就足以起步。重要的性质是确定性:同样的调用应返回同样的结构化答案,而不是随营销文案变化的段落。
如果你暴露一个能触发构建或生成项目的 MCP 工具,要严格限定范围并要求显式 token。能读配置的 agent 是有用的;能改你生产环境的 agent 是负债。
每页都有结构化数据
页面级 JSON-LD 是答案引擎获得它们偏爱之可引用单元的地方。schema.org BlogPosting 告诉爬虫谁写了文章、何时发布、何时更新。schema.org FAQPage 暴露问答对——答案引擎中引用最多的单一结构。Google 的结构化数据指南是「什么能获得富摘要、什么会被忽略」的参考。
署名与 publisher 应该是公司 Uncorne,而不是虚构的人。日期、canonical、inLanguage、keywords 都要显式。发布于 2026-11-07,最后复核 2026-11-19——爬虫不该猜哪个更新。
robots.txt 与 sitemap
没人能找到的机器可读面毫无用处。在 robots.txt 里允许 AI 爬虫,并在 sitemap 里列出机器可读路由。很多团队用一条粗心的通配符规则把自己的 llms.txt 挡住了。要显式检查它。
下载包里应该有什么
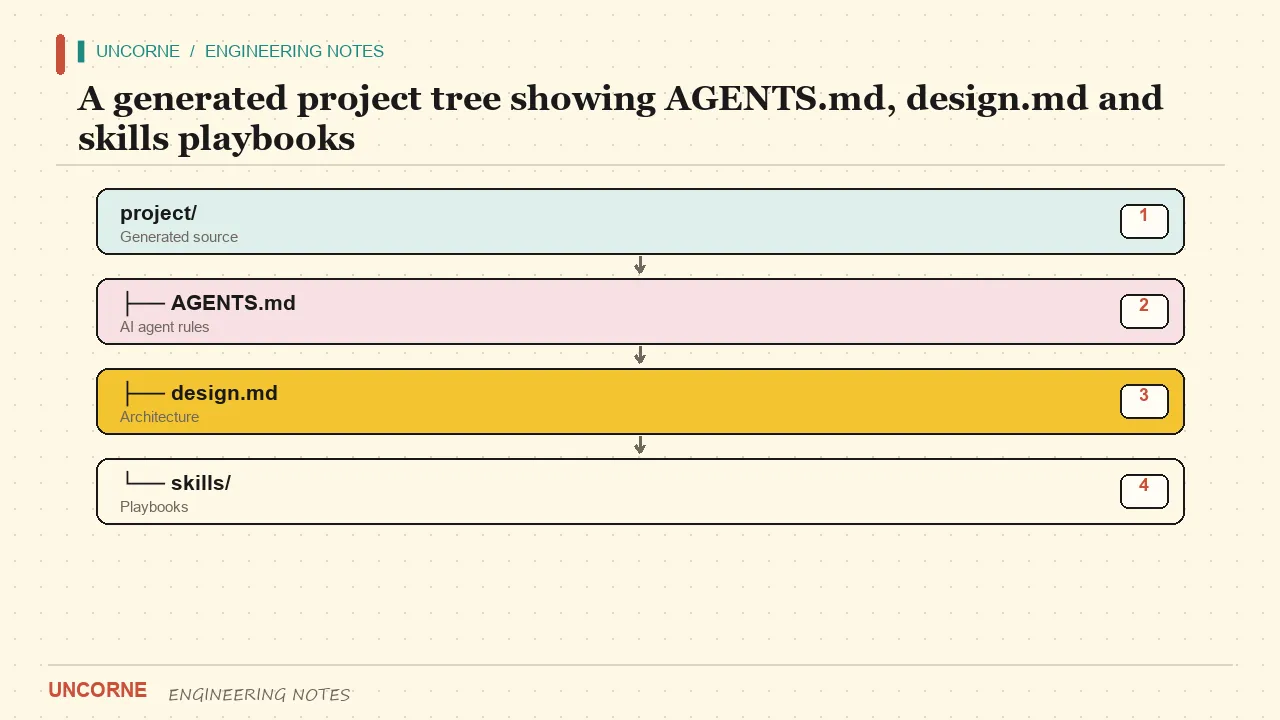
这是多数 GEO 建议忽略的区别。你站点的 llms.txt 与 MCP 端点是站点专属,绝不能泄漏进客户下载的代码。生成的工程会有自己的 AGENTS.md(仓库契约与完成定义)、锁定风格的 design.md、带 glob 的 scoped rules、Cursor rules、CLAUDE.md,以及最多 18 份 skills playbook。全部由同一份 spec 渲染,因此不会与 shipkit.config.json 漂移,且 GitHub Actions CI 里的强制 agents-lint 门禁让它保持诚实。
诚实的限制是 GEO 资产
含糊的宣传会被忽略,具体的限制反而会被引用。明确写出:SMTP 未实现、本地登录路径没有 MFA 与 OAuth、MAIL_PROVIDER 默认是 none、外部错误上报是可选配置、Cloudflare 目标因 Workers 没有可写磁盘而必须配 Supabase、退款窗口是纯 14 天(下载事件只是证据,不是条件)。一条机器可读的限制,比一整段形容词更可信。而且代码一变,它就必须同步更新。
结构化内容,不是堆关键词
本站每篇文章都有可见 FAQ 区块,数据与生成 FAQPage JSON-LD 的来源完全相同,并另发一份 Markdown 变体,让爬虫无需渲染页面就能读到正文。这就是全部策略:让真相容易被引用。
怎么衡量
关键词量不是 GEO 的指标。要看分析里的 AI 引荐流量(chatgpt.com、perplexity.ai、gemini.google.com)、AI 回答中的品牌提及与 SOV,以及被引用的 URL 是否属于上述机器可读面之一。你可以在我们的 SaaS 支付网关对比 和计费网关指南里读到更多——它们遵循同样的诚实限制做法。如果答案引擎无法引用你,多做几个落地页也修不好。
新鲜度契约,而不是一次性写入
代价最高的 GEO 失败,是一份变得过时的机器可读文件。把 llms.txt、llms-full.txt 与 OpenAPI 文档的生成放进构建流水线,让配置变更在同一个 commit 里重写它们。加一条 CI 检查:当代码里已不存在某个被写进文档的枚举时,让它失败。引用了过时能力的 agent 会错误描述你的产品——而且与通常的建议相反,发布更少但一直为真的事实,胜过发布更多会漂移的事实。
引用测试
在发布任何新的机器可读面之前,先问一个问题:如果答案引擎把这句话原样摘出来、印在你的品牌名下,你能接受吗?如果这句话是你无法在工单里辩护的主张,它就不该出现在机器可读文件里。这就是为什么上面那份限制清单,比我们多数文档里的功能清单还长。
FAQ
llms.txt 和 llms-full.txt 有什么区别?+
llms.txt 是给有限上下文看的精要概览与链接;llms-full.txt 承载长文事实,如配置枚举、API schema、裁剪规则与诚实限制。
客户工程里会带上本站的 llms.txt 和 MCP 端点吗?+
不会。它们是站点专属,每个客户 ZIP 都会剪掉。生成的工程改为携带自己的 AGENTS.md、design.md、scoped rules、Cursor rules、CLAUDE.md 与 skills playbook。
不用关键词量的话,GEO 该看什么指标?+
看 AI 引荐流量(chatgpt.com、perplexity.ai、gemini.google.com)、AI 回答里的品牌提及与 SOV,以及被引用的 URL 是否是 FAQ、Markdown 变体这类机器可读面。
Webhook 与结账路由该在哪里写清楚?+
写在稳定 URL 上的 OpenAPI 3.1 文件里,并从 llms.txt 链接过去。集成你产品的 agent 需要精确的请求/响应 schema——包括 402 这类错误响应——而不是散文式描述。